


行业资讯
多模态大模型如何重构安全生产视频分析
发布日期:2026-09-02 10:35 浏览次数:
2024 年以来,视觉语言模型(VLM)和多模态大模型开始从实验室走向产业应用。在安全生产的 AI 视频分析领域,这意味着一场范式的变化。
过去十年,安全生产视频分析的基本范式是「一个场景、一个算法、一个模型」:安全帽识别一个模型、烟火检测一个模型、越界识别一个模型。场景越多、风险种类越多,算法就越碎片化,部署和运维越复杂。
多模态大模型有可能改变这个格局。
一、传统安全生产视频分析的瓶颈
传统视频分析本质是「目标检测 + 行为规则」的组合,在标准化场景(安全帽佩戴、区域入侵)已经成熟,但有明显上限:
|
瓶颈 |
表现 |
|
泛化能力弱 |
换一个场景、一个摄像头角度,往往要重新调参或训练 |
|
语义理解浅 |
能识别「有人」,但难以理解「这个人正在违章作业」 |
|
算法碎片化 |
每新增一种风险,就要新增一个模型 |
|
交互能力有限 |
只能看告警列表,无法用语言追问 |
二、多模态大模型带来了什么
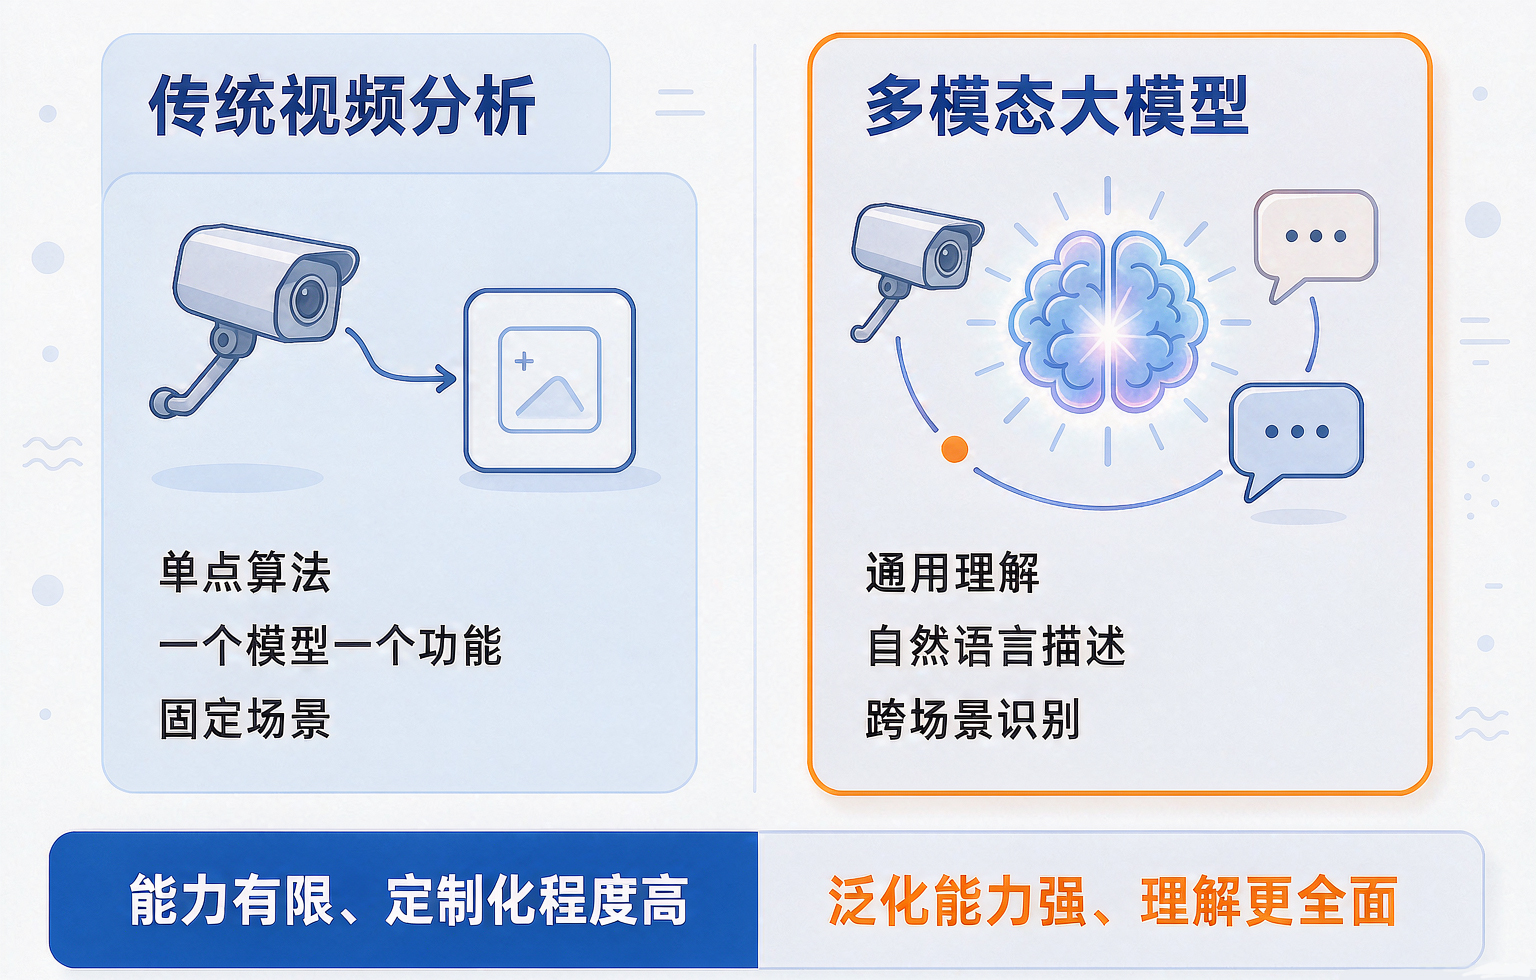
多模态大模型的核心变化,是把「图像/视频理解」和「自然语言理解」统一到一个模型里,带来五点能力提升:
- 自然语言描述:自动描述画面事件,如「作业人员未佩戴安全带,正在 2 号平台附近作业」
- 开放词汇识别:不用预训练每个类别,用自然语言提示即可识别
- 事件级理解:不只检测目标,而是理解「发生了什么」
- 跨场景泛化:对未见过的新场景具备更强迁移能力
- 人机自然交互:用户可直接用自然语言追问「刚才仓库门口发生了什么」
未来的安全生产视频分析,可能不再是一个个孤立算法的堆砌,而是一个能「看懂画面、理解事件、用语言沟通」的统一视觉智能体。
三、多模态大模型在安全生产中的落地场景
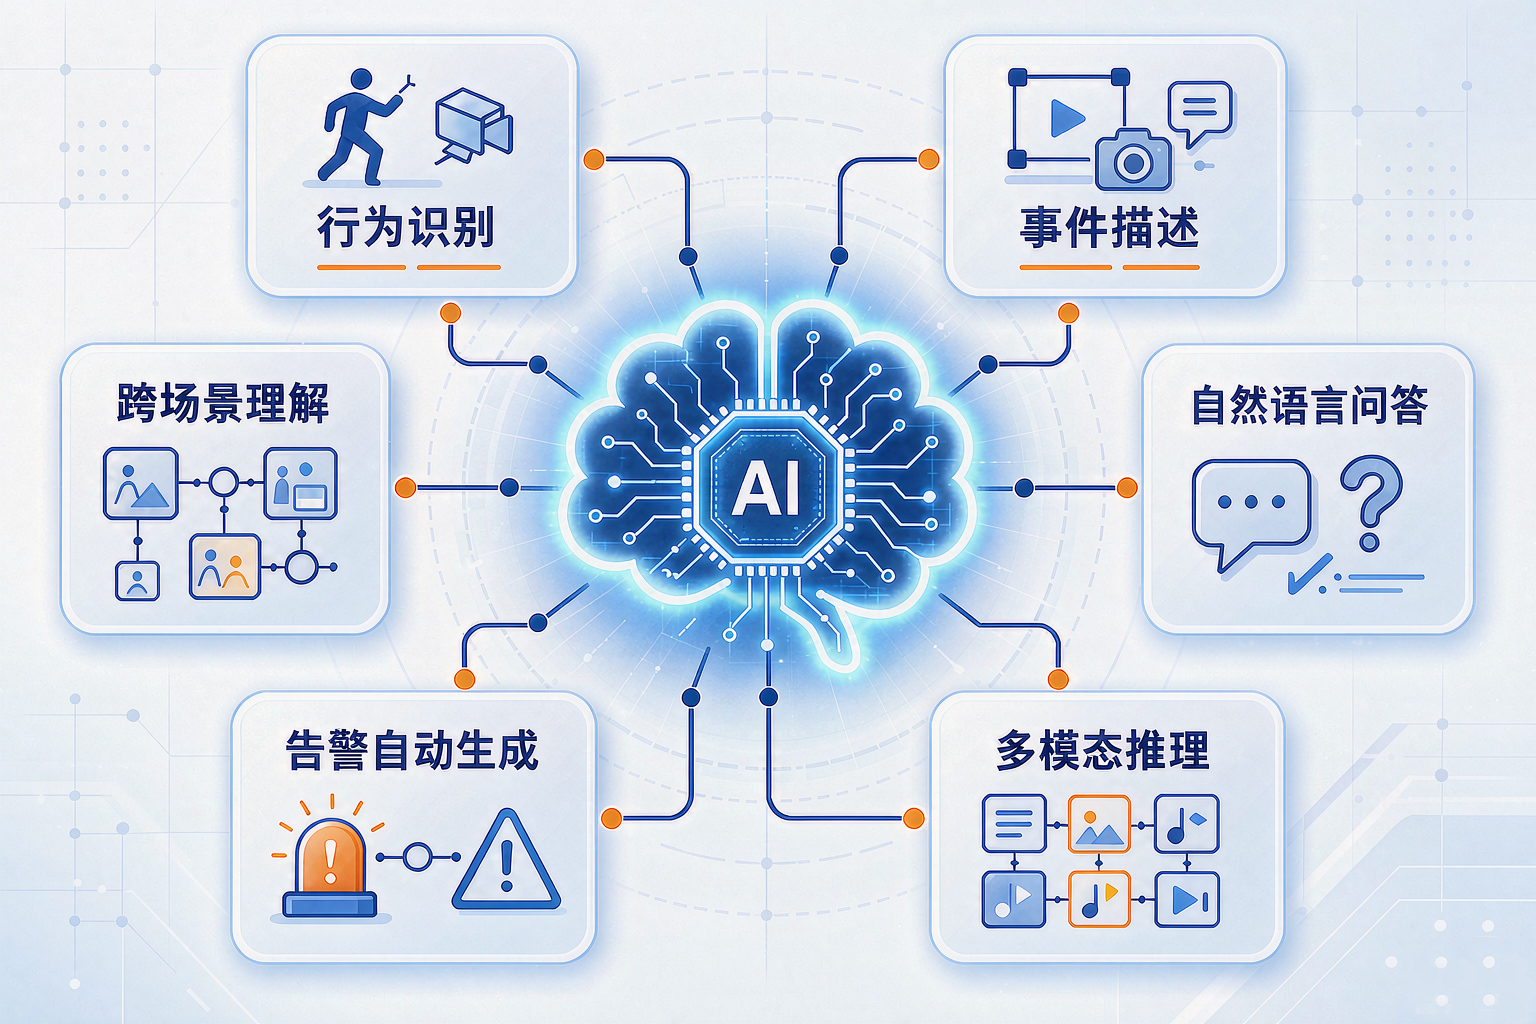
在钢铁冶金、化工、电力、煤矿、危化品仓储等安全生产场景,多模态大模型至少能在五个方向发挥作用:
1. 人员不安全行为识别
传统算法擅长判断「有没有戴安全帽、有没有穿反光衣」,但对更复杂的违章行为——作业流程是否合规、工具是否被带出作业区、多人协同是否规范——识别能力有限。多模态大模型可通过语义理解,对复杂行为给出更接近人类判断的描述。
2. 设备与环境异常监测
结合温度、液位、气体等传感器数据,多模态大模型可对「设备异常」「环境参数超限」「泄漏征兆」等复杂状态进行语义融合判断,而不只依赖单一阈值触发。
3. 事件回溯与长视频摘要
安全生产事件往往不是一瞬间发生的。多模态大模型可对长视频生成自然语言摘要,帮助安全管理人员快速回溯事故经过,不用再逐帧查录像。
4. 自然语言告警查询
安全员不再需要在告警列表里翻找,而是直接问系统:「今天有哪些未按规定佩戴劳保用品的事件?」系统返回对应时间段、点位画面和处理建议。
5. 应急处置辅助
事件发生时,大模型可结合现场画面与预案库,自动生成处置建议和人员调度提示,为应急响应争取时间。
四、落地工业场景的现实挑战
多模态大模型潜力大,但要在安全生产场景真正落地,还有几个关键问题:
- 实时性:工业监控要求秒级响应,大模型推理成本远高于传统小模型,如何在边缘设备实现低延迟是工程第一关
- 算力与成本:大模型对算力要求高,中小项目需通过模型蒸馏、大小模型协同来控成本
- 幻觉与误报:大模型可能生成与画面不符的描述。在安全生产这种高敏感场景,一次错误理解可能带来严重后果,必须与传统检测算法、规则引擎相互校验
- 数据安全:厂区视频涉及企业核心生产资料,私有化部署、边缘推理仍是主流,云端方案需满足数据不出厂等合规要求
五、从「算法叠加」到「统一视觉智能」
多模态大模型不会立刻取代传统视频分析,而是推动行业双向演进:
- 短期:大小模型协同——传统小模型负责实时检测和高频告警(安全帽、烟火、越界),大模型负责复杂场景理解、事件摘要、自然语言交互,兼顾实时性与理解深度
- 中长期:统一视觉理解平台——当推理成本和延迟降到足够低,一套模型可替代大量单点算法。届时系统的主要工作不再是「新增算法」,而是「调整自然语言规则」
六、倍特威视的布局方向
作为长期专注安全生产 AI 视频分析的厂商,我们认为多模态大模型不是替代现有方案,而是提升方案上限的新工具。当前重点方向:
- 已有算法精度提升:用大模型语义理解能力,辅助降低传统算法误报率
- 复杂场景理解补充:在已有检测能力上,增加事件级描述与回溯能力
- 自然语言交互:探索基于大模型的告警查询、事件摘要、处置建议生成
- 边缘-云协同:大模型按需部署在云端或私有化服务器,实时检测继续下沉到边缘盒子
无论底层模型如何演进,看得准、报得准、响应快、数据不出厂,始终是安全生产 AI 视频分析的核心诉求。
七、展望
多模态大模型给安全生产视频分析带来的最大改变,是让机器对视频的理解方式从「标签匹配」走向「语义理解」。
这意味着:系统会更像一位 24 小时在岗的安全助理;管理人员可以用自然语言与视频系统对话;异常事件能被更全面地描述、更快地定位、更准确地处置。
方向已经清晰:大模型 + 小模型 + 工程化能力,将是下一阶段安全生产 AI 视频分析的主流架构。
